Cursor AI vs ChatGPT: wat verandert als AI je software bouwt?Leestijd: maximaal 11 minuten
Wat gebeurt er met je manier van werken als AI niet meer alleen code schrijft, maar daadwerkelijk software voor je gaat bouwen? Bij Cursor AI vs ChatGPT draait het dan niet om de mooiste losse code. Het gaat om de hele route: een opdracht begrijpen, de juiste bestanden vinden, iets aanpassen, testen en fouten herstellen. En om de vraag die daarna overblijft: hoeveel moet jij nog controleren voordat je het resultaat durft te gebruiken?
Cursor AI vs ChatGPT: vergelijk eerst het werk, niet het antwoord
Stel dat een kleine Nederlandse webwinkel een tweede afleveradres wil toevoegen. Op het scherm lijkt dat één extra keuzevakje. Achter de schermen kan dezelfde wijziging gevolgen hebben voor het formulier, de opslag, de bevestiging en bestaande bestellingen.
Je kunt ChatGPT vragen hoe je zo’n functie zou aanpakken. Dat is nuttig als je de mogelijkheden wilt begrijpen of een plan wilt bespreken. Maar een goed antwoord in een gesprek is nog geen werkende wijziging in je project.
Cursor kan als coding agent bestanden onderzoeken, code aanpassen en opdrachten uitvoeren om het resultaat te controleren. OpenAI biedt met Codex eveneens een coding agent die met projectbestanden kan werken. Daarom is ‘Cursor versus ChatGPT’ eigenlijk een vergelijking tussen drie werkwijzen: praten over code in gewone ChatGPT-chat, bouwen in Cursor en bouwen met Codex.
Dat onderscheid voorkomt een veelvoorkomend misverstand. Wie alleen een los chatantwoord naast Cursor legt, vergelijkt niet twee gelijkwaardige bouwprocessen. Wie Codex meeneemt, kan wél kijken hoe beide agentomgevingen een opdracht van begin tot eind behandelen.

Wil je eerst rustig begrijpen hoe de editor zelf werkt? In onze uitleg over Cursor AI behandelen we de basis. Hier kijken we naar de keuze die daarna komt.
Eén opdracht, drie verschillende werkervaringen
Neem opnieuw het tweede afleveradres. Een zorgvuldige route ziet er zo uit:
Opdracht → context verzamelen → plan → aanpassen → testen → fout oplossen → review → opleveren.
| Stap | Gewone ChatGPT-chat | Cursor Agent | Codex |
|---|---|---|---|
| Context verzamelen | Jij deelt de relevante informatie | De agent kan in het project zoeken | De agent kan in een gekoppeld project werken |
| Plan maken | Je bespreekt een aanpak | Je kunt eerst een plan laten opstellen | Je kunt een taak en randvoorwaarden meegeven |
| Aanpassen | Je verwerkt een antwoord zelf | De agent kan projectbestanden wijzigen | De agent kan projectbestanden wijzigen |
| Testen | Je deelt resultaten of foutmeldingen terug | De agent kan controles uitvoeren | De agent kan controles uitvoeren |
| Review | Jij beoordeelt wat je hebt overgenomen | Jij beoordeelt de wijzigingen | Jij beoordeelt de wijzigingen |
De tabel zegt bewust niet welke tool ‘wint’. De uitkomst hangt ook af van de toegang die je geeft, de gekozen werkomgeving en de kwaliteit van je opdracht.

Voor iemand die nog nooit code heeft aangepast, kan een gesprek de prettigste eerste stap zijn. Voor iemand die dagelijks in een bestaande applicatie werkt, telt juist hoeveel zoek- en plakwerk verdwijnt. En bij een goed afgebakende taak kan het aantrekkelijk zijn om een agent zelfstandig een voorstel te laten maken.
Tegenintuïtief inzicht: de snelste eerste versie is niet altijd de snelste oplevering. Een agent kan in korte tijd veel bestanden wijzigen. Als niemand goed kan zien waarom, verschuift de tijdwinst naar een lange review.
Context is geen stapel bestanden
Bij een klein project kun je de belangrijkste code nog overzien. Bij vijftig of vijfhonderd bestanden wordt dat lastiger. Dan bepaalt niet alleen de kwaliteit van het AI-model de uitkomst, maar ook welke informatie het systeem vindt en gebruikt.
Denk aan een WordPress-plugin die door verschillende mensen is aangepast. Een status als ‘afgerond’ staat misschien in een formulier, een e-mailtemplate en een export. Een agent die alleen het formulier vindt, kan een keurige wijziging maken die toch onvolledig is.
Dat verklaart waarom ‘de AI heeft mijn hele project gelezen’ geen geruststellende conclusie is. Toegang tot een project is iets anders dan de juiste afhankelijkheden herkennen. Ook een agent moet kiezen wat relevant is. Ontbreekt een belangrijke afspraak of een oude uitzondering, dan kan de code logisch ogen en toch verkeerd uitpakken.
Nog een tegenintuïtief inzicht: meer context geven kan een resultaat slechter maken. Verouderde documentatie en overbodige bestanden kunnen de aandacht afleiden van de werkelijke opdracht. Een scherpe vraag helpt daarom meer dan ‘kijk maar naar alles’.
Vraag bij een grotere wijziging eerst: Welke bestanden zijn volgens jou betrokken, welke aannames maak je en wat wil je nog controleren? Het antwoord laat zien of de agent de situatie goed heeft afgebakend. Pas daarna wordt code schrijven interessant.
De belangrijkste maat: hoe vaak moet een mens ingrijpen?
Een vergelijking op basis van ‘mooie code’ blijft snel een kwestie van smaak. Bij WegwijsAI zouden we liever meten hoeveel werk een ontwikkelaar nodig heeft om van de eerste poging naar een verantwoord bruikbaar resultaat te komen.
Daarvoor kun je een eenvoudige Human Intervention Score gebruiken. Tel niet alleen prompts, maar ook de momenten waarop iemand inhoudelijk moet bijsturen:
- Correctie: de AI past iets verkeerd of onvolledig aan.
- Ontbrekende context: iemand moet een belangrijke projectafspraak alsnog uitleggen.
- Herstel: een wijziging veroorzaakt een nieuwe fout.
- Review: iemand moet onverwacht veel uitzoekwerk doen om de wijziging te vertrouwen.
Die score is geen universeel cijfer voor een tool. Het is een meetmethode voor jouw taak en jouw project. Eén correctie op een ingewikkelde architectuurkeuze kan belangrijker zijn dan drie kleine tekstwijzigingen.
Een ontwikkelaar bij een bureau herkent dit waarschijnlijk. Een klant vraagt om ‘even’ een extra veld in een aanvraagformulier. De AI voegt het veld toe en het scherm ziet er goed uit. Tijdens de review blijkt dat het veld niet in de e-mail aan de klant staat. Daarna blijkt het ook te ontbreken in een export die het bureau maandelijks oplevert. De eerste versie was snel; de echte opdracht was groter dan het scherm.
Precies daar verandert het werk. De ontwikkelaar schrijft mogelijk minder zelf, maar moet scherper vaststellen wat ‘klaar’ betekent.
Een goed model is nog geen goede bouwpartner
Waarom kan dezelfde programmeervraag in twee omgevingen anders uitpakken? Omdat het antwoord niet alleen van het model afhangt.
Een coding agent krijgt instructies, gebruikt hulpmiddelen om bestanden te vinden of te wijzigen en ontvangt feedback uit bijvoorbeeld tests. Die onderdelen bepalen samen wat het systeem kan controleren en welke fout het misschien zelf ontdekt.
Zie het als een verbouwing. Een vakmens met een goede bouwtekening, passend gereedschap en toegang tot de meterkast kan meer dan dezelfde vakmens met alleen een foto van de woonkamer. Bij AI geldt iets vergelijkbaars: model + relevante context + hulpmiddelen + instructies + controle = resultaat.
Daarom zouden wij bij WegwijsAI niet vragen: ‘Welke AI is het slimst?’ De bruikbaardere vraag is: Welke werkwijze maakt een verkeerde aanname op tijd zichtbaar?
De fouten die juist door snelheid ontstaan
AI kan een functie gebruiken die niet in het project bestaat. Het kan een extra pakket toevoegen terwijl er al een passende oplossing aanwezig is. Of het schrijft een test die alleen bevestigt wat de nieuwe code zelf al aanneemt.
Het lastigste geval is niet altijd een duidelijke foutmelding. Soms werkt de nieuwe functie prima, maar wordt de code moeilijker te onderhouden. Een toekomstige collega moet dan uitzoeken waarom er twee bijna gelijke routes voor afleveradressen bestaan.
Vraag daarom niet alleen: ‘Werkt het?’ Vraag ook:
- Welke bestaande onderdelen veranderen hierdoor mee?
- Is er code toegevoegd die niet nodig was?
- Controleren de tests ook het gedrag van oude bestellingen?
- Welke aannames zijn nog niet bewezen?
- Kan iemand anders de wijziging later begrijpen?
Een agent die een fout zelf herstelt, is nuttig. Maar een geslaagde test is geen bewijs dat alle gevolgen zijn gecontroleerd. De kwaliteit van de controle hangt af van wat die test daadwerkelijk nagaat.
Wat kost AI-coding werkelijk?
Abonnementskosten zijn zichtbaar. Reviewtijd meestal niet. Toch kan juist die tijd bepalen of een tool voor een bureau, freelancer of team voordelig is.
Gebruik daarom dit rekenmodel:
Totale kosten per taak = toolgebruik + tijd voor de opdracht + reviewtijd + herstelwerk + tijd door wisselen tussen omgevingen.
Stel als rekenvoorbeeld, niet als gemeten resultaat, dat tool A per maand goedkoper is maar bij een specifieke taak extra review vraagt. Dan kan de goedkoopste licentie alsnog de duurdere werkwijze zijn. Andersom kan een uitgebreidere agent onnodig zijn als je vooral korte vragen over code stelt.
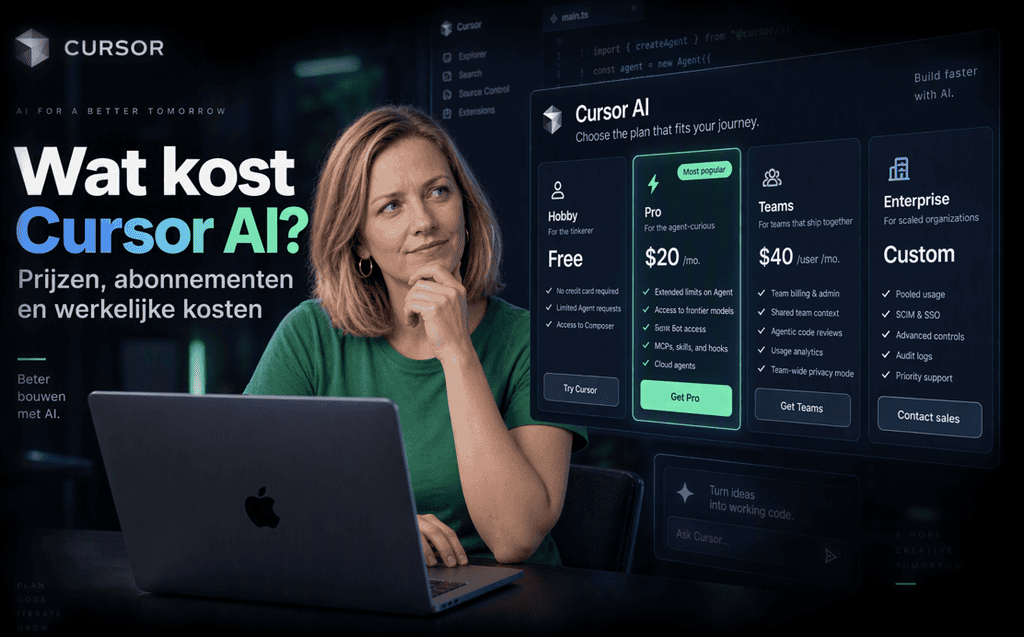
Actuele abonnementsprijzen en voorwaarden veranderen. Daarom houden we die buiten deze vergelijking. Voor de afzonderlijke prijsinformatie kun je wat kost Cursor AI raadplegen. Controleer vóór publicatie of die geplande pagina live staat: ik kon de inhoud ervan tijdens dit onderzoek niet ophalen.
Welke werkwijze past bij jou?
| Jouw situatie | Kijk vooral naar |
|---|---|
| Je leert programmeren | Begrijpelijke uitleg en zicht op fouten |
| Je werkt dagelijks in een bestaande codebase | Snel de juiste context vinden en wijzigingen beoordelen |
| Je bouwt een eerste prototype | Snelheid van proberen én eenvoud van herstellen |
| Je onderhoudt oudere software | Aannames, afhankelijkheden en bestaande tests |
| Je werkt met meerdere ontwikkelaars | Afspraken, toegangsrechten en review |
| Je wilt taken op afstand laten uitvoeren | Heldere opdrachten, veilige toegang en controle achteraf |
Cursor kan goed passen bij iemand die dicht op de code wil blijven werken. Gewone ChatGPT-chat kan helpen om een probleem te verkennen of een aanpak te begrijpen. Codex is relevant zodra je OpenAI’s coding agent wilt inzetten voor werk aan projectbestanden. Dat zijn keuzerichtingen, geen uitslag van een praktijktest.
Wil je eerst breder bepalen welke AI-tool bij je werk past? Gebruik dan de WegwijsAI-keuzehulp voor AI-tools. Kom daarna terug naar één concrete programmeertaak. Die vertelt je meer dan een algemene ranglijst.
De echte verandering: je wordt regisseur én controleur
Als AI software bouwt, verdwijnt het menselijke werk niet. Het verschuift. Je moet duidelijker zeggen wat het probleem is, welke grenzen gelden en hoe je vaststelt dat iets echt werkt.
Dat kan ook als je nog niet technisch bent. Begin niet met ‘bouw mijn hele app’, maar met een kleine, controleerbare wijziging. Vraag om uitleg vóór uitvoering en laat iemand met programmeerkennis meekijken voordat een wijziging in een echte website of applicatie terechtkomt.
De beste keuze tussen Cursor AI en ChatGPT is dus niet de tool die het indrukwekkendst typt. Het is de werkwijze waarin jij op tijd ziet wat de AI heeft begrepen, veranderd en misschien over het hoofd heeft gezien.
Wil je AI voor je werk rustig leren beoordelen? Begin bij de WegwijsAI-keuzehulp en probeer daarna één kleine taak met duidelijke controlepunten.
Dit artikel is opgesteld voor Maarten en Sanne van WegwijsAI.
Veelgestelde vragen
Is Cursor beter dan ChatGPT om software te bouwen?
Niet voor iedere taak. Cursor richt zich sterk op werken in en rond een codeproject. ChatGPT is ook bruikbaar om vragen te verkennen en code te laten uitleggen. Neem je Codex mee, dan vergelijk je bovendien twee coding-agentworkflows. De beste keuze hangt af van je project, de beschikbare context en hoeveel controle je wilt houden.
Kan ik zonder programmeerkennis een agent een app laten bouwen?
Je kunt een opdracht formuleren en een prototype laten maken. Maar zonder technische controle is het lastig om te beoordelen of gegevens goed worden verwerkt, bestaande functies blijven werken en de code later te onderhouden is. Begin klein en laat belangrijke wijzigingen beoordelen.
Hoe vergelijk ik Cursor en Codex eerlijk?
Gebruik dezelfde taak, dezelfde projectversie en vooraf vastgelegde controlepunten. Meet niet alleen de tijd tot de eerste versie, maar ook correctierondes, testuitkomsten en menselijke reviewtijd. Publiceer pas een winnaar als je die resultaten daadwerkelijk hebt gemeten.
Over de auteur