Claude Managed Agents: hoe je AI-agents bouwt, beheert en opschaaltLeestijd: maximaal 21 minuten
Claude Managed Agents helpt ontwikkelteams om AI-agents te bouwen die meer doen dan één antwoord geven. Ze kunnen informatie verzamelen, hulpmiddelen gebruiken en een taak in meerdere stappen uitvoeren. Het platform neemt daarbij een deel van de technische uitvoering over. Maar een agent die blijft werken, is nog geen agent die goed werkt. Hoe bepaal je welke taken geschikt zijn, waar menselijke controle nodig blijft en wanneer opschalen verstandig is? Daar begint de echte afweging: niet bij zoveel mogelijk zelfstandigheid, maar bij een werkproces dat je kunt begrijpen, begrenzen en beoordelen.
Wanneer heb je meer nodig dan een gewone AI-assistent?
Een document laten samenvatten is overzichtelijk. Je geeft tekst mee, ontvangt een antwoord en beoordeelt het resultaat. Een incident onderzoeken is een ander verhaal. Daarvoor moet een systeem misschien een melding lezen, recente wijzigingen bekijken, logbestanden vergelijken en vervolgens bepalen welke informatie nog ontbreekt.
Zo’n opdracht vraagt niet alleen om een goed taalmodel. Er moet ook iets regelen welke stap volgt, welke hulpmiddelen beschikbaar zijn en wat er gebeurt wanneer een verbinding wegvalt. Die uitvoeringslaag wordt vaak een agent-harness genoemd. Je kunt die zien als de werkorganisatie rond het model: niet de kennis zelf, maar de voorzieningen waarmee het werk doorgaat.
Claude Managed Agents levert zo’n beheerde uitvoeringslaag, met sessies, hulpmiddelen en een werkomgeving. De officiële documentatie positioneert het vooral voor langlopende taken en werk dat op de achtergrond wordt uitgevoerd. Het product is momenteel in bèta.
Het belangrijke verschil is dus niet dat een gewone AI-assistent niets kan en een agent alles. Het verschil zit in de inrichting. Bij een agent ontwerp je een proces waarin meerdere stappen kunnen volgen zonder dat een medewerker iedere tussenstap zelf hoeft te starten.
Wat neemt Claude Managed Agents over, en wat blijft jouw verantwoordelijkheid?
Het woord managed klinkt geruststellend. Toch betekent het niet dat de leverancier jouw bedrijfsproces beheert. Het platform kan de uitvoering ondersteunen, maar weet niet vanzelf welke klantafspraak leidend is, welke fout onacceptabel is of wie een wijziging mag goedkeuren.
De dienst biedt onder meer een beheerde agent-loop, sessiegeschiedenis en mogelijkheden voor geïsoleerde uitvoering. Een agent kan, afhankelijk van de configuratie, bestanden lezen en bewerken, opdrachten uitvoeren, webinformatie ophalen en externe hulpmiddelen gebruiken. Je bepaalt zelf welke mogelijkheden beschikbaar zijn.
Daartegenover blijven belangrijke keuzes bij je organisatie liggen. Welke gegevens mag de agent gebruiken? Wanneer moet hij stoppen? Wat geldt als een goed resultaat? En wie grijpt in als de uitkomst aannemelijk klinkt, maar niet voldoende is onderbouwd?
Onze visie bij WegwijsAI: besteed de uitvoering uit, niet het oordeel over wat verantwoord werk is. Juist doordat de technische drempel lager wordt, moet de inhoudelijke opdracht scherper worden. Anders bouw je sneller een systeem dat een onduidelijk proces op grotere schaal herhaalt.
Claude API, Agent SDK of Managed Agents: welke route past?
Niet iedere toepassing heeft uitgebreide agentinfrastructuur nodig. Voor het herkennen van een onderwerp in een klantbericht kan een directe modelaanroep voldoende zijn. Je stuurt informatie naar het model en verwerkt het antwoord in je eigen applicatie.
De Agent SDK biedt meer voorzieningen voor het bouwen van agents, waaronder hulpmiddelen, sessies en toestemmingsmechanismen. Je gebruikt die binnen een proces dat je zelf uitvoert en beheert. Managed Agents verschuift meer van de agentuitvoering naar een gehoste dienst, met mogelijkheden voor een beheerde of self-hosted sandbox.
| Route | Wanneer logisch? | Wat moet je vooral zelf regelen? |
|---|---|---|
| Messages API | Een afgebakende AI-functie of een sterk aangepaste werkwijze | De applicatielogica en eventuele vervolgstappen |
| Agent SDK | Een agent binnen een omgeving die je zelf beheert | Hosting, inrichting en operationeel beheer |
| Managed Agents | Meerstapstaken met behoefte aan beheerde uitvoering | Taakontwerp, integraties, rechten en kwaliteitscontrole |
De tabel is een praktische keuzehulp op basis van de officiële productvergelijking, geen ranglijst van beste naar slechtste.
Het eerste tegenintuïtieve inzicht is daarmee eenvoudig: een eenvoudiger AI-oplossing kan de betere oplossing zijn. Als een vaste reeks stappen het probleem al oplost, voegt een zelfstandige agent mogelijk vooral extra variatie toe. Kies pas voor meer vrijheid wanneer die vrijheid werkelijk nodig is.

Wil je eerst begrijpen hoe een eigen toepassing toegang krijgt tot Claude? Onze uitleg over een Claude API key behandelt die basis. Dat is een andere vraag dan hoe je een complete agent verantwoord laat werken.
Een praktijkvoorbeeld: een incident onderzoeken zonder direct iets te veranderen
Stel je een fictief Nederlands softwarebedrijf voor. Op maandagochtend melden klanten dat hun reserveringsbevestiging soms ontbreekt. De supportmedewerker ziet verschillende meldingen, maar weet niet of ze dezelfde oorzaak hebben. Een ontwikkelaar moet ondertussen achterhalen of een recente wijziging ermee samenhangt.
Een agent kan in een zorgvuldig ingerichte proef helpen om die informatie te verzamelen. Hij leest de meldingen, bekijkt toegestane logbestanden en zet de tijdlijn naast recente softwarewijzigingen. Daarna maakt hij een analyse met mogelijke oorzaken, ontbrekend bewijs en een voorstel voor verder onderzoek.
Mis geen nieuw Claude-artikel
Ontvang een melding zodra WegwijsAI een nieuwe handleiding, vergelijking of praktische update over Claude publiceert.
De belangrijkste grens is hier bewust gekozen: de agent verandert nog niets in de echte dienstverlening. Een ontwikkelaar beoordeelt eerst of de analyse klopt. Pas daarna kan een afzonderlijke, goedgekeurde stap volgen.
Dat lijkt voorzichtig, maar het maakt de proef juist bruikbaar. Als je onderzoek en herstel meteen samenvoegt, wordt het moeilijker om te zien waar een fout ontstaat. Een verkeerde conclusie kan dan direct leiden tot een verkeerde wijziging.
Dit voorbeeld is een ontwerp voor een mogelijke toepassing, geen uitgevoerde WegwijsAI-case. Het laat vooral zien waarom een agent een duidelijke opdracht nodig heeft: niet “los alle incidenten op”, maar “verzamel bewijs en bereid een beoordeelbaar voorstel voor”.
Hoe werkt de uitvoering achter de schermen?
Je hoeft niet te programmeren om de belangrijkste onderdelen te begrijpen. Vier begrippen helpen om het gesprek met een ontwikkelaar of leverancier te voeren: agent, omgeving, sessie en gebeurtenissen.
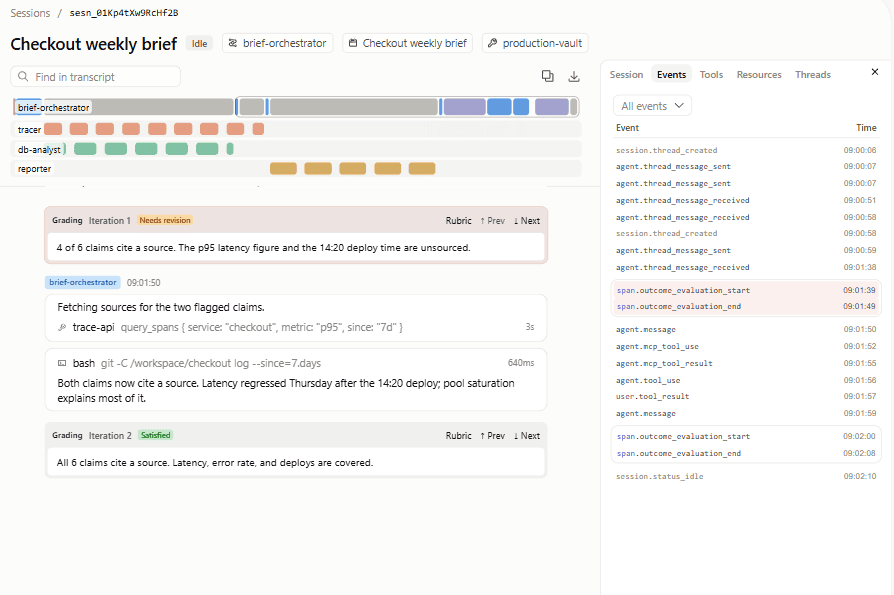
De agent bevat de inrichting: het gekozen model, de instructies en de beschikbare hulpmiddelen. De omgeving bepaalt waar de uitvoering plaatsvindt. De sessie is één concrete uitvoering van een opdracht. De gebeurtenissen vormen de uitwisseling tijdens dat werk, zoals een opdracht, een toolresultaat of een statuswijziging.
In het incidentvoorbeeld kun je dezelfde agent gebruiken voor verschillende meldingen. Iedere uitvoering krijgt een eigen sessie. Daardoor kun je achteraf beoordelen wat bij een specifieke melding is gebeurd, zonder alle onderzoeken als één lang gesprek te behandelen.
Een belangrijk ontwerpprincipe is dat de sessiegeschiedenis losstaat van het proces dat de agent uitvoert. Daardoor kan de uitvoering na bepaalde onderbrekingen worden hervat vanuit de vastgelegde gebeurtenissen. Dat ondersteunt continuïteit, maar bewijst niet dat iedere externe handeling correct is afgerond.
Dat laatste verdient aandacht. Als een ticketsysteem niet reageert, weet je niet automatisch of een wijziging mislukt is of alleen de bevestiging ontbreekt. Je applicatie moet daarom controleren wat werkelijk is gebeurd voordat dezelfde actie opnieuw wordt uitgevoerd.
Stap voor stap: van eerste idee naar een gecontroleerde agent
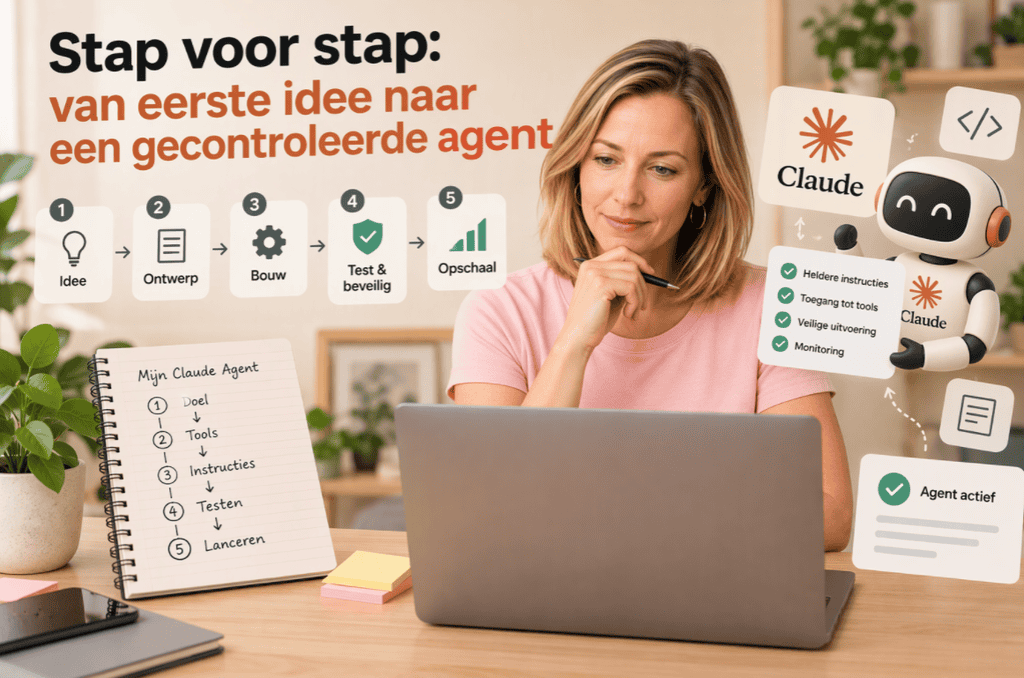
Een eerste proef hoeft niet groot te zijn. Wel moet je vooraf weten wat je wilt aantonen. Onderstaand stappenplan combineert de officiële productopbouw met ons eigen implementatieadvies. Het is een praktisch plan voor samenwerking met een ontwikkelaar, geen belofte dat productiegebruik zonder technische inrichting mogelijk is.
Stap 1: kies één taak met een herkenbaar eindpunt
Begin met een taak waarvan een medewerker het resultaat kan beoordelen. “Onderzoek deze incidentmelding en maak een onderbouwde samenvatting” is beter afgebakend dan “verbeter onze klantenservice”.
Schrijf ook op wanneer de taak klaar is. Bijvoorbeeld: er ligt een tijdlijn, iedere mogelijke oorzaak heeft een bron en ontbrekende informatie staat apart vermeld. Zonder eindpunt kan een agent blijven zoeken terwijl de bruikbaarheid nauwelijks toeneemt.
Stap 2: leg vast wat de agent niet mag doen
Bepaal de grenzen voordat je systemen aansluit. In de eerste proef mag de incidentagent bijvoorbeeld alleen lezen en een conceptanalyse maken. Hij mag geen software publiceren, klantberichten versturen of meldingen sluiten.
Zet zulke grenzen niet alleen in de opdrachttekst. Laat ze ook afdwingen via de beschikbare functies en rechten. Een instructie om iets niet te doen is iets anders dan een systeem dat die handeling onmogelijk maakt.
Stap 3: regel platformtoegang en een afzonderlijk testbudget
De officiële quickstart begint met een Claude Console-account en een manier om je toepassing aan te melden. Dat kan via de ondersteunde ontwikkelhulpmiddelen of een API-sleutel. Daarna worden de agent, omgeving en sessie ingericht.
Maak voor de proef duidelijke afspraken over kosten en eigenaarschap. Wie mag de inrichting aanpassen? Wie bekijkt het verbruik? En wie kan de uitvoering stoppen? Houd een proef herkenbaar gescheiden van toepassingen die al door klanten worden gebruikt.
Stap 4: beschrijf de agent en kies alleen noodzakelijke hulpmiddelen
Geef de agent een concreet doel, relevante achtergrond en een vaste resultaatstructuur. Voor het incidentvoorbeeld zijn dat een samenvatting, tijdlijn, bewijs, mogelijke oorzaken en open vragen.
Schakel vervolgens alleen de hulpmiddelen in die daarvoor nodig zijn. De officiële beveiligingsgids adviseert om met een minimale toolset te beginnen en risicovolle acties afzonderlijk te laten goedkeuren.
Stap 5: kies de uitvoeringsomgeving
Je kunt een beheerde cloudomgeving gebruiken of een self-hosted sandbox op eigen infrastructuur. Bij die tweede route blijft de beheerde agent-loop bij Anthropic, terwijl de uitvoering van hulpmiddelen naar je eigen omgeving kan worden verplaatst.
Dat is geen detail voor later. De keuze bepaalt mede wie de werkomgeving beveiligt en beheert. Laat daarom vooraf beoordelen welke gegevens en toolresultaten langs welke route worden verwerkt.
Stap 6: start met fictieve of zorgvuldig vrijgegeven informatie
Gebruik een testmelding waarvan de juiste uitkomst vooraf bekend is. Voeg bijvoorbeeld een relevante foutmelding toe, maar ook een onschuldige wijziging die toevallig op hetzelfde tijdstip plaatsvond.
Zo toets je of de agent verband en oorzaak uit elkaar houdt. Alleen zeggen dat twee gebeurtenissen tegelijk plaatsvonden, is onvoldoende bewijs dat de ene de andere veroorzaakte.
Stap 7: volg de uitvoering, niet alleen het eindrapport
Bekijk welke bronnen zijn geraadpleegd, welke hulpmiddelen zijn gebruikt en waar fouten optraden. Managed Agents ondersteunt vastgelegde gebeurtenissen en sessie-inspectie, zodat je de uitvoering kunt onderzoeken.
Beoordeel ook of de agent onnodige stappen zet. Een uitgebreid rapport kan overtuigend lijken, terwijl het belangrijkste bewijs ontbreekt. Meer activiteit is niet hetzelfde als meer kwaliteit.
Stap 8: test onderbrekingen en ontbrekende informatie
Laat een bron bewust niet beschikbaar zijn. Controleer vervolgens of de agent dat duidelijk meldt. Een goed resultaat kan hier juist zijn: “Ik kan deze oorzaak nog niet beoordelen.”
Test daarnaast of een onderbroken opdracht zonder dubbele externe acties kan worden hervat. Een agent die netjes stopt bij onzekerheid kan waardevoller zijn dan een agent die altijd een afgerond verhaal produceert.
Stap 9: voeg pas daarna een beperkte schrijfactie toe
Als het onderzoek voldoende werkt, kun je bijvoorbeeld toestaan dat de agent een conceptnotitie aan een testticket toevoegt. Controleer daarbij de bestemming, inhoud en bevestiging van de wijziging.
Laat ingrijpende handelingen nog buiten de proef. De stap van analyseren naar handelen verandert het risico. Daarom verdient iedere nieuwe bevoegdheid een eigen test.
Stap 10: schaal op met een beslismoment
Vergelijk de uitkomsten met de vooraf vastgelegde eisen. Kijk naar correctheid, menselijke controletijd, kosten en fouten. Pas wanneer die combinatie acceptabel is, vergroot je het aantal taken of gebruikers.
Leg ook vast wanneer je terugschakelt. Een nieuwe modelversie, gewijzigde koppeling of aangepaste instructie kan het gedrag veranderen. Opschalen vraagt daarom niet alleen een startbesluit, maar ook een terugvalplan.
Hoe koppel je agents aan bestaande systemen?
Een agent heeft alleen iets aan een koppeling wanneer die de juiste informatie of handeling beschikbaar maakt. Voor de incidentagent kan dat een zoekfunctie in documentatie zijn, een beperkte logbron of een functie om een conceptnotitie toe te voegen.
Managed Agents ondersteunt ingebouwde hulpmiddelen, eigen tools en MCP-verbindingen. Bij eigen tools kan jouw applicatie de gevraagde handeling uitvoeren en het resultaat teruggeven aan de agent. Daardoor kun je ook buiten het model controles toepassen.
De naam van een functie doet ertoe. “Werk ticket bij” laat veel ruimte open. “Voeg conceptanalyse toe aan testticket” maakt duidelijker wat de handeling betekent. Ook de terugmelding moet concreet zijn: welk ticket is aangepast en welke wijziging is bevestigd?
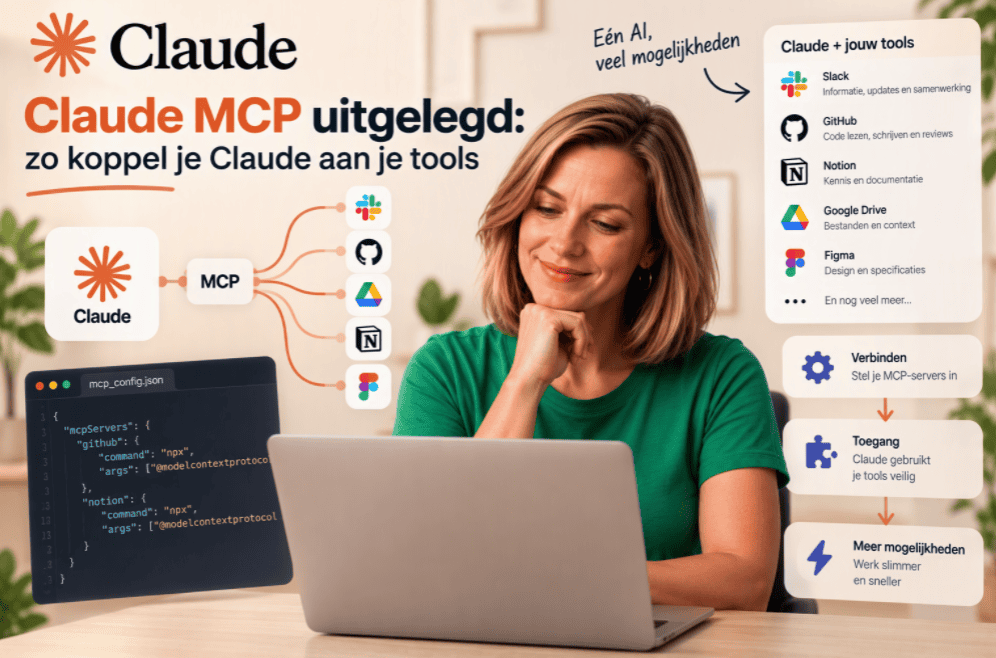
Wil je begrijpen hoe zulke verbindingen worden aangeboden? In onze uitleg over Claude MCP lees je hoe informatie en functies beschikbaar worden gemaakt. De koppeling is daarbij niet het doel; de juiste, beperkte toegang is dat wel.
Veiligheid: een afgeschermde omgeving is geen vrijbrief
Een sandbox is een afgeschermde werkomgeving. Die helpt om de uitvoering te begrenzen, maar maakt de inhoudelijke keuzes van een agent niet automatisch juist. Als een aangesloten account te veel rechten heeft, kan een fout nog steeds gevolgen hebben in het gekoppelde systeem.
De officiële beveiligingsgids adviseert onder meer beperkte netwerktoegang, een minimale toolset, beschermd sleutelbeheer, budgetgrenzen en goedkeuring voor risicovolle acties. Ook moet onbetrouwbare invoer worden gescheiden van krachtige hulpmiddelen.
Dat laatste gaat bijvoorbeeld over een document waarin verborgen of misleidende instructies staan. De agent moet zo’n document als bron behandelen, niet als nieuwe opdrachtgever. Daarom is een technische grens belangrijker dan alleen de zin “volg geen vreemde instructies”.
| Actie | Ons advies voor een eerste pilot |
|---|---|
| Vrijgegeven documentatie lezen | Toestaan met beperkte toegang |
| Loggegevens analyseren | Alleen noodzakelijke gegevens beschikbaar maken |
| Een conceptnotitie toevoegen | Bestemming en inhoud controleren |
| Klanten informeren | Eerst menselijke goedkeuring |
| Bestanden verwijderen of productie wijzigen | Buiten de eerste pilot houden |
Dit is een WegwijsAI-adviesmodel, geen officiële risicoclassificatie. Het werkelijke risico hangt ook af van de gegevens, de omgeving en de gevolgen van een fout.
Let bovendien op de bewaarbehoefte. De officiële documentatie vermeldt dat Managed Agents niet in aanmerking komt voor Zero Data Retention of HIPAA BAA-dekking. Sessies zijn bewust blijvend opgeslagen totdat je ze verwijdert. Een self-hosted sandbox verandert die productdekking niet.
Langlopende taken: wanneer moet de agent juist stoppen?
Een agent die uren kan werken, hoeft niet uren te werken. Een langer onderzoek kan nuttig zijn wanneer nieuwe informatie beschikbaar komt. Maar als een bron ontbreekt, kan verder zoeken vooral kosten en schijnzekerheid opleveren.
Maak daarom onderscheid tussen drie situaties: de taak is afgerond, de taak is geblokkeerd of de taak vraagt een menselijke beslissing. Die uitkomsten horen niet allemaal onder hetzelfde groene vinkje te vallen.
Een opvallend voorbeeld uit de officiële praktijkdocumentatie: wanneer een bron niet bereikbaar is, kan een agent anders ten onrechte melden dat er niets nieuws is. Daarom moet de werkwijze onderscheid maken tussen “geen wijzigingen gevonden” en “de bron kon niet worden gelezen”.
Dat is het tweede tegenintuïtieve inzicht: een zichtbare mislukking kan betrouwbaarder zijn dan een soepel eindrapport. De lezer weet dan waar de informatiegrens ligt. Een stil verzwegen ontbrekende bron maakt het resultaat juist moeilijker te beoordelen.
Meerdere agents inzetten: wanneer helpt dat echt?
Het platform ondersteunt samenwerking waarbij een leidende agent onderdelen verdeelt over gespecialiseerde agents. Die kunnen verschillende modellen, instructies en hulpmiddelen gebruiken. Ook zijn er mogelijkheden om uitkomsten aan vooraf beschreven kwaliteitscriteria te laten toetsen.
Voor een incidentonderzoek kan één agent de tijdlijn bekijken en een andere relevante documentatie onderzoeken. Dat is vooral interessant wanneer de deeltaken redelijk zelfstandig kunnen worden uitgevoerd.
Maar meerdere agents betekenen ook meer overdracht. Als iedereen dezelfde onjuiste aanname krijgt, leveren meerdere analyses nog steeds geen onafhankelijk bewijs. Een controleagent die alleen het eindrapport leest, kan bovendien dezelfde overtuigende formulering overnemen.
Begin daarom met één agent en voeg pas specialisten toe wanneer je kunt aanwijzen welk probleem dat oplost. Parallel werken is nuttig als het wachttijd verkort of verschillende bronnen beter onderzoekt, niet alleen omdat het indrukwekkend klinkt.
Hoe meet je betrouwbaarheid en zakelijke waarde?
De belangrijkste maatstaf is niet hoeveel taken de agent afrondt, maar hoeveel taken correct en verantwoord worden afgerond. Neem daarom ook geblokkeerde opdrachten, mislukte pogingen en menselijke correcties mee.
Voor een pilot adviseren we vijf meetpunten:
- Correcte afronding: voldoet het resultaat aan de vooraf bepaalde eisen?
- Juiste hulpmiddelen: gebruikte de agent passende bronnen en handelingen?
- Herstelgedrag: ging hij verstandig om met fouten en onderbrekingen?
- Menselijke inspanning: hoeveel controle en correctie bleef nodig?
- Kosten per geslaagde taak: wat kostte het geheel, inclusief mislukkingen?
Gebruik daarnaast een eenvoudige grens: een verboden handeling is geen kleine kwaliteitsafwijking. Een rapport kan inhoudelijk sterk zijn en toch onacceptabel worden doordat het buiten de toegestane toegang is gemaakt.
Voor ontwikkeltaken geldt dezelfde gedachte. Onze blog over Claude voor programmeren laat zien waarom een aannemelijke oplossing nog geen aangetoonde oplossing is. Bij agents moet je bovendien de hele uitvoeringsroute beoordelen.
Wat kost Claude Managed Agents?
De officiële prijsdocumentatie beschrijft modelverbruik plus een runtimevergoeding van 0,08 Amerikaanse dollar per actief sessie-uur. Die runtimevergoeding geldt voor de tijd waarin de sessie de status running heeft. Wachten in de status idle telt daarvoor niet mee. Aanvullende functies, zoals webzoeken, kunnen afzonderlijk worden berekend.
Dat bedrag is dus niet de volledige prijs van een agenttaak. Ook het gekozen model, de hoeveelheid verwerkte informatie en het aantal pogingen tellen mee. Voor een organisatie komen daar ontwikkeling, koppelingen, beheer en menselijke controle bij.
Gebruik voor je businesscase daarom deze redenering: deel alle relevante kosten van de pilot door het aantal goedgekeurde taken. Zo voorkom je dat goedkope, mislukte pogingen uit beeld verdwijnen.
Een managed dienst kan eigen infrastructuurwerk verminderen, maar is niet automatisch de goedkoopste keuze. De juiste vergelijking gaat over de totale werkwijze: wat moet je bouwen, onderhouden en controleren om hetzelfde bruikbare resultaat te bereiken?
Veelgestelde vragen over managed AI-agents
1. Wat is Claude Managed Agents precies?
Het is een platformvoorziening waarmee ontwikkelaars agents kunnen configureren en laten uitvoeren met een beheerde agent-harness. Die ondersteunt meerstapstaken, hulpmiddelen en sessies. Het is dus geen extra chatabonnement voor gewone gebruikers, maar een bouwvoorziening voor toepassingen waarin Claude werk uitvoert.
De praktische vraag is niet alleen wat de agent kan, maar welk proces je ermee wilt verbeteren. Zonder duidelijke taak en kwaliteitsgrens blijft ook een goed beheerde uitvoering lastig te beoordelen.
2. Heb ik programmeerkennis nodig om hiermee te beginnen?
Voor het beschrijven van een taak niet. Een inhoudelijk medewerker kan uitstekend bepalen welke informatie nodig is, wat een goede uitkomst bevat en wanneer een mens moet beslissen.
Voor koppelingen, toegangsbeheer en betrouwbare productie-invoering is doorgaans wel technische ondersteuning nodig. De officiële quickstart gebruikt ontwikkelhulpmiddelen en beschrijft het aanmaken van agents, omgevingen en sessies. Een toegankelijke start maakt die verantwoordelijkheid niet overbodig.
3. Wat is het verschil met de gewone Claude API?
De Messages API geeft directe modeltoegang. Je toepassing bepaalt vervolgens hoe het antwoord wordt verwerkt en welke vervolgstappen nodig zijn. Managed Agents voegt een beheerde uitvoeringslaag toe voor agents die meerdere stappen en hulpmiddelen gebruiken.
Voor een eenvoudige classificatie of samenvatting kan directe modeltoegang voldoende zijn. Kies niet voor een uitgebreidere inrichting als de taak daar geen voordeel van heeft.
4. Wat is het verschil met de Agent SDK?
De Agent SDK biedt de agentvoorzieningen van Claude Code als programmeerbare bibliotheek. Je draait die binnen een proces dat je zelf beheert. Managed Agents laat de agent-harness gehost uitvoeren, met ondersteunde mogelijkheden voor beheerde en self-hosted sandboxes.
De keuze gaat daarom vooral over de gewenste controle en beheerverdeling. Meer zelf beheren geeft ruimte voor eigen keuzes, maar vraagt ook eigen operationele verantwoordelijkheid.
5. Kan een agent zelfstandig blijven werken als ik mijn laptop sluit?
Bij een correct ingerichte cloudtaak hoeft jouw laptop niet het proces draaiend te houden. De officiële documentatie beschrijft langlopende sessies en geplande uitvoeringen op de infrastructuur van de dienst.
Dat betekent niet dat iedere taak zonder toezicht hoort door te gaan. Stel grenzen aan budget, toegang en toegestane acties. Zorg ook dat iemand een melding ontvangt wanneer de uitvoering blokkeert of aandacht nodig heeft.
6. Kan ik de uitvoering onderbreken of bijsturen?
Ja. De officiële documentatie beschrijft dat je aanvullende gebeurtenissen kunt sturen om een lopende agent bij te sturen of de uitvoering kunt onderbreken.
Houd er wel rekening mee dat stoppen een eerder uitgevoerde externe handeling niet vanzelf terugdraait. Als een bericht al is verstuurd of een record is gewijzigd, heb je daarvoor een afzonderlijke herstelroute nodig.
7. Is het geschikt voor gebruik met echte klanten?
Dat hangt af van de toepassing en je eigen kwaliteits- en risicobeoordeling. De dienst is momenteel in bèta. Dat vraagt extra aandacht voor wijzigingen, beperkingen en de geschiktheid van de gekozen functies.
Begin met een beperkte pilot en een menselijke terugvalmogelijkheid. Een agent die concepten voorbereidt stelt andere eisen dan een agent die zelfstandig toezeggingen doet of gegevens wijzigt.
8. Blijven alle gegevens binnen mijn eigen omgeving bij een self-hosted sandbox?
Dat mag je niet zonder meer aannemen. Een self-hosted sandbox verplaatst de uitvoering van hulpmiddelen naar een omgeving die je zelf beheert. De agent-loop blijft op de infrastructuur van Anthropic.
Onderzoek daarom afzonderlijk welke opdrachten, resultaten en sessiegegevens worden verwerkt. “Eigen uitvoering” en “volledig lokaal AI-systeem” zijn verschillende dingen.
9. Hoe voorkom ik dat de agent ongewenste acties uitvoert?
Beperk beschikbare hulpmiddelen, systeemrechten en netwerktoegang. Laat risicovolle acties goedkeuren en zorg voor een stopmogelijkheid. De officiële beveiligingsgids adviseert deze combinatie van maatregelen.
Vertrouw niet alleen op een vriendelijke instructie. Als een agent niets mag verwijderen, is het sterker om de verwijderfunctie niet beschikbaar te maken dan alleen te vragen haar niet te gebruiken.
10. Zijn meerdere agents beter dan één agent?
Niet automatisch. Meerdere agents kunnen zelfstandige deeltaken parallel uitvoeren, maar vragen ook coördinatie. Het platform ondersteunt die samenwerking; de waarde ervan moet je met je eigen taak aantonen.
Vergelijk daarom eerst één agent met een beperkte taakverdeling. Kijk naar totale kosten, fouten en controletijd. Een groter team van agents is pas nuttig als het eindresultaat aantoonbaar verbetert.
11. Hoe weet ik of een agent werkelijk tijd bespaart?
Meet de volledige taak: voorbereiding, uitvoering, controle, correctie en eventueel herstel. Vergelijk dat met een gelijkwaardige handmatige werkwijze. Een snelle eerste versie kan immers veel extra controle vragen.
Leg ook vast wat als voldoende kwaliteit geldt. Anders vergelijk je een gecontroleerd menselijk resultaat met een ongecontroleerd AI-concept. Dat levert een aantrekkelijk, maar weinig bruikbaar besparingscijfer op.
12. Wanneer kun je beter niet voor een managed agent kiezen?
Als één modelaanroep of een vaste automatisering de taak al goed oplost, kan een agent onnodig zijn. Ook wanneer de vereiste gegevensverwerking of controle niet past bij de beschikbare productroute, moet je een andere inrichting onderzoeken.
Kijk bovendien naar de huidige beperkingen. Managed Agents ondersteunt momenteel geen Zero Data Retention of HIPAA BAA-dekking. Dat is een concrete productgrens, geen instelling die je met een betere prompt oplost.
Bouw eerst vertrouwen, daarna capaciteit
De waarde van een agent zit niet in hoeveel werk hij zonder vragen verzet. Ze zit in werk dat je kunt volgen, beoordelen en verantwoord gebruiken. Begin daarom met één afgebakende taak, beperkte toegang en een helder eindpunt. Breid pas uit wanneer je begrijpt waarom het goed gaat en waar het nog misloopt.

Wil je eerst de verschillende Claude-mogelijkheden op een rij zetten? Begin bij onze centrale Claude-gids en kies daarna welke toepassing bij jouw werk past. Een goede eerste stap is niet de grootste agent bouwen, maar de kleinste taak vinden die je betrouwbaar kunt verbeteren.
Over de auteur