Gemini 4 Argon: 10 toepassingen en grenzen uitgelegdLeestijd: maximaal 10 minuten
Gemini 4 Argon belooft hulp bij werk dat niet in één vraag past: een softwareproject doorgronden, documenten vergelijken of een onderzoek uitwerken. Volgens de officiële modelkaart is het model juist voor zulke complexe opdrachten ontwikkeld. Maar een indrukwekkende score vertelt nog niet hoeveel controlewerk jij overhoudt. In dit artikel bekijken we tien toepassingen en grenzen. Niet vanuit de vraag welk model de meeste aandacht krijgt, maar welk werk je er verantwoord aan kunt overlaten.
1. Waarvoor is Gemini 4 Argon werkelijk bedoeld?
Een korte tekst herschrijven is iets anders dan uitzoeken waarom drie documenten elkaar tegenspreken. Bij die tweede opdracht moet een model informatie combineren, tussenstappen uitvoeren en rekening houden met eerdere bevindingen.
Google positioneert Argon voor zulke meerstapsopdrachten, onder andere bij softwareontwikkeling, financiële en juridische analyse en onderzoek. Het verwerkt tekst, afbeeldingen, audio en video. De eigen uitvoer bestaat uit tekst.
Dat laatste onderscheid is belangrijk. Een toepassing kan extra gereedschappen aanbieden, maar daarmee zijn die functies nog geen ingebouwde uitvoermogelijkheden van het model.
Onder de motorkap gebruikt Argon een mixture-of-experts-architectuur. Eenvoudig gezegd: niet alle onderdelen van het model worden voor ieder stukje verwerking even sterk ingezet. De modelkaart noemt daarnaast training met meerstapsredeneringen en probleemoplossing. Dat beschrijft de aanpak, maar bewijst niet dat iedere opdracht goed eindigt.
Onze voorgestelde WegwijsAI-visie: beoordeel een model niet op hoeveel het kan vertellen, maar op hoeveel bruikbaar werk overblijft na controle.
2. Een oude applicatie begrijpen voordat je iets verandert
Stel je een Nederlands installatiebedrijf voor met een oud planningssysteem. De oorspronkelijke ontwikkelaar is vertrokken. Een aanpassing aan de planning veroorzaakt soms een fout in de facturatie.
Dit is een fictief praktijkscenario. Het laat zien waarom samenhang belangrijker is dan snel nieuwe code produceren.
Een bruikbare eerste opdracht is niet: “Verbeter dit systeem.” Vraag eerst welke onderdelen elkaar beïnvloeden, waar onzekerheden zitten en welke tests ontbreken.
Google beschrijft eigen toepassingen bij grote softwaremigraties. Daarbij noemt het bedrijf nadrukkelijk automatische controles, handmatige beoordelingen en tests vóór ingebruikname. Dat zijn leveranciersvoorbeelden, geen garantie voor jouw project.
Een tegenintuïtief inzicht: meer gegenereerde code kan minder vooruitgang betekenen. Je moet immers ook meer beoordelen. Meet daarom liever:
- hoeveel bestaande tests blijven slagen;
- hoeveel nieuwe fouten ontstaan;
- hoeveel tijd de beoordeling kost;
- hoeveel wijzigingen achteraf worden teruggedraaid.
Een kleine, aantoonbaar werkende verbetering is waardevoller dan een indrukwekkende herschrijving.
3. Financiële documenten vergelijken zonder conclusies cadeau te doen
Een omzetstijging lijkt goed nieuws. Maar wat als dezelfde organisatie een bedrijf heeft overgenomen? Dan betekent een hoger totaal niet automatisch dat de bestaande activiteiten beter presteren.
Hier ligt een mogelijke toepassing: informatie uit verschillende documenten naast elkaar zetten. Argon scoort in de gepubliceerde vergelijking 65,4% op Vals Finance Agent v2, tegenover 53,5% voor GPT-6 Astra. Die test gaat volgens de introductie over financiële research in meerdere stappen.
Voor jouw werk is vooral de controleerbaarheid belangrijk. Laat het model daarom drie dingen scheiden:
- Wat staat letterlijk in de documenten?
- Welke berekening volgt daaruit?
- Welke verklaring is nog slechts een mogelijkheid?
Een bruikbare opdracht luidt:
Vergelijk deze rapportages. Noteer per bevinding het document, de pagina en de gebruikte cijfers. Scheid vastgestelde verschillen van mogelijke verklaringen. Benoem ontbrekende informatie.
Gebruik dit als voorbereiding op deskundige beoordeling, niet als zelfstandig financieel advies.
4. Contracten naast elkaar leggen: verschillen zijn nog geen oordeel
Bij een leveranciersovereenkomst staan afspraken zelden netjes op één plek. Het hoofdcontract verwijst naar voorwaarden. Een bijlage bevat uitzonderingen. Een latere wijziging past een termijn aan.
Een model kan helpen om zulke passages te verzamelen en naast elkaar te zetten. Google noemt juridische documentanalyse als beoogde toepassing.
De nuttige vraag is daarom niet meteen: “Is dit contract goed?” Begin met: “Welke passages spreken over hetzelfde onderwerp en waar wijken ze af?”
De benchmark vraagt bovendien om bescheidenheid. Argon staat in de aangeleverde vergelijking bovenaan bij Harvey’s Legal Agent Benchmark, maar de score is 19,6%. Dat is geen bewijs dat zelfstandig juridisch werk betrouwbaar kan worden overgenomen.
Laat een jurist de betekenis beoordelen. Een gevonden verschil kan belangrijk zijn, maar ook bewust zijn afgesproken.
5. Beveiligingswerk: vinden, beoordelen, herstellen en testen
Een beveiligingsmelding oplossen bestaat uit meerdere taken. Eerst moet duidelijk worden wat er speelt. Daarna volgen prioritering, een herstelvoorstel en controle van de oplossing.
Google rapporteert voor Argon 68,0% op CWE-bench v1, gelijk aan GPT-6 Astra. Deze benchmark beoordeelt het herstellen van softwarekwetsbaarheden.
Dat cijfer ondersteunt een gerichte toepassing, niet de conclusie dat een systeem na één AI-controle veilig is.
Houd daarom vier stappen apart:
- Signaleren: welke aanwijzing verdient onderzoek?
- Beoordelen: wat betekent die voor deze omgeving?
- Herstellen: welke wijziging is passend?
- Valideren: werkt de oplossing zonder nieuwe problemen?
Beperk dit tot systemen waarvoor je toestemming hebt. Laat wijzigingen eerst in een afgeschermde testomgeving beoordelen.
6. Onderzoek versnellen zonder een hypothese voor bewijs aan te zien
Een goed geformuleerde verklaring voelt al snel overtuigend. Toch zijn een mogelijke verklaring, een berekend resultaat en experimenteel bewijs verschillende dingen.
Argon is volgens de modelkaart bedoeld voor wetenschappelijk en wiskundig redeneren. De gepubliceerde vergelijking laat daarbij geen uniforme winnaar zien: Argon staat hoger op LABBench 2 en RiemannBench, terwijl GPT-6 Astra hoger scoort op Terminal-Bench Science 0.1.
Een praktische toepassing is een onderzoeksvraag scherper maken. Laat bijvoorbeeld benoemen welke aannames een conclusie nodig heeft en welke informatie haar zou kunnen weerleggen.
Vraag ook expliciet:
Welke onderdelen van je antwoord volgen uit de aangeleverde bronnen, en welke onderdelen zijn jouw interpretatie?
Zo gebruik je AI als onderzoekshulp, niet als bewijsautomaat.
7. Eén miljoen tokens: een grote werktafel, geen perfect geheugen
Het contextvenster is de hoeveelheid materiaal waarmee een model binnen een verwerking kan werken. Tokens zijn kleine stukjes tekst of andere gecodeerde informatie.
De officiële documentatie noemt voor Argon een gezamenlijk budget van 1.048.576 tokens. Invoer, redeneerverwerking en uitvoer delen dat budget. Een gewone aanvraag levert bovendien niet automatisch een antwoord van één miljoen tokens op; voor zeer lange uitvoer gelden aanvullende verwerkingsstappen.
Zie het als een grote werktafel. Er past veel op, maar daarmee is niet gegarandeerd dat ieder detail goed wordt gebruikt.
De GraphWalks-scores maken die nuance zichtbaar. Argon behaalt 99,7% F1 bij de kortere selectie en 84,2% bij de selectie van 256.000 tot één miljoen tokens. Het gaat om verschillende testselecties, dus niet om een zuivere meting van alleen het lengte-effect.
Tweede tegenintuïtieve inzicht: minder materiaal aanleveren kan de betere werkwijze zijn. Niet omdat extra context per definitie schaadt, maar omdat een gerichte selectie eenvoudiger te controleren is.
8. Van losse opdracht naar gecontroleerde workflow
Een agent is hier een AI-toepassing die meerdere stappen uitvoert en daarbij gereedschappen kan gebruiken. De omgeving bepaalt wat mogelijk is en welke toestemming nodig is.
Argon ondersteunt volgens de productdocumentatie onder andere code-uitvoering en het aanroepen van functies. Computerbediening wordt als previewfunctie genoemd.
Een gecontroleerde route van bugmelding naar wijzigingsvoorstel kan er zo uitzien:
- Laat de melding samenvatten.
- Verzamel relevante bestanden en foutinformatie.
- Vraag om mogelijke oorzaken met onderbouwing.
- Laat een beperkte wijziging voorstellen.
- Voer tests uit in een aparte omgeving.
- Laat een medewerker het voorstel goedkeuren.
Het belangrijkste ontwerpbesluit is waar het model moet stoppen. Een conceptwijziging maken is iets anders dan haar zelfstandig publiceren.
Wil je die route eerst zonder ingewikkelde koppelingen uitdenken? Onze uitleg over een AI-workflow maken helpt je om beginpunt, verwerking en controle logisch te ordenen.
9. Gemini 4 Argon vergelijken: wat zeggen de benchmarks?
Een benchmark is een vaste testverzameling. De score vertelt hoe een model binnen die testopzet presteert. Niet hoe vaak het in jouw organisatie gelijk krijgt.
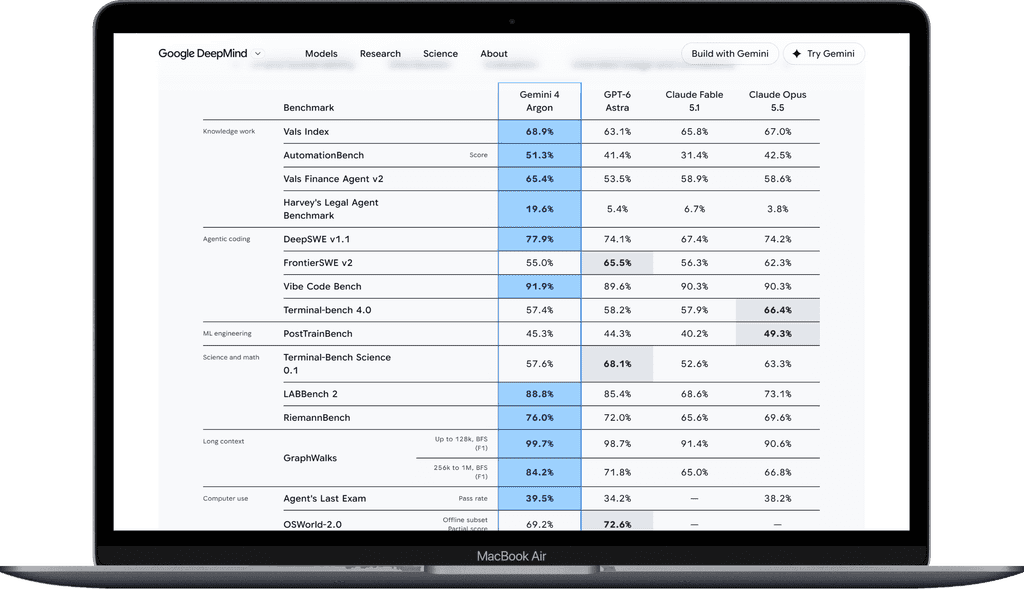
Onderstaande cijfers komen uit de officiële modelkaart. De methodiek combineert eigen metingen, openbare ranglijsten en door aanbieders gerapporteerde resultaten. Argon is doorgaans getest met de hoogste redeneerinstelling.
| Benchmark | Argon | GPT-6 Astra | Fable 5.1 | Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68,9% | 63,1% | 65,8% | 67,0% |
| AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Harvey’s Legal Agent Benchmark | 19,6% | 5,4% | 6,7% | 3,8% |
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
| LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% |
| RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% |
| GraphWalks tot 128k, F1 | 99,7% | 98,7% | 91,4% | 90,6% |
| GraphWalks 256k–1M, F1 | 84,2% | 71,8% | 65,0% | 66,8% |
| Agent’s Last Exam, slaagpercentage | 39,5% | 34,2% | Niet vermeld | 38,2% |
| OSWorld-2.0, offline deelscore | 69,2% | 72,6% | Niet vermeld | Niet vermeld |
| Chartography | 71,6% | 71,0% | 46,2% | 66,3% |
| LVBench | 91,7% | 87,5% | 79,7% | 83,7% |
| CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% |
Zo lees je de verschillende tests
De categorieën meten verschillende soorten werk. Vals Index bundelt beroepsgerichte prestaties. AutomationBench kijkt naar uitvoering van zakelijke taken. De softwaretests beoordelen uiteenlopende ontwikkelopdrachten. PostTrainBench gaat over machinelearningwerk. De wetenschappelijke tests onderzoeken weer andere vaardigheden.
GraphWalks gebruikt F1: een maat die gevonden juiste antwoorden en gemiste of onjuiste antwoorden combineert. Agent’s Last Exam rapporteert een slaagpercentage. OSWorld toont hier een gedeeltelijke score op een offline selectie. Die percentages kun je dus niet zomaar middelen.
Chartography onderzoekt grafiekbegrip en LVBench begrip van lange video’s. Bij LVBench kregen modellen niet hetzelfde aantal beelden aangeboden, vanwege verschillen in de beschikbare interfaces. Ook koos Google bij OSWorld de hoogste score uit drie runs. Zulke details beïnvloeden de interpretatie.
Het veelvoorkomende misverstand is daarmee duidelijk: de meeste vetgedrukte scores maken een model niet automatisch de beste keuze.
Wil je ook het verschil tussen de toepassingen bekijken, in plaats van alleen deze modelversies? Lees dan onze vergelijking Claude versus Gemini.
10. Kosten en beperkingen: tel het herstelwerk mee
De standaard API-prijzen bedragen tot en met 30 november 2026 $2 per miljoen invoertokens en $10 per miljoen uitvoertokens. Vanaf 1 december worden dat $4 en $20. Redeneertokens tellen mee bij de uitvoerkosten. Dit zijn API-tarieven, geen maandprijzen voor de consumentenapp.
De modelkaart noemt daarnaast mogelijke verzonnen informatie, traagheid en time-outs. De kennisgrens is maart 2026; sommige onderwerpen kunnen minder actueel zijn.
Kijk daarom naar de volledige taak:
Totale inspanning = voorbereiding + modelgebruik + controle + correcties + implementatie.
Een externe praktijktest van Analytics Vidhya illustreert waarom. Het model beoordeelde acht documentclaims correct, maar voegde in de uiteindelijke samenvatting toch een niet-onderbouwde formulering toe. Dat is één specifieke test, geen algemene foutfrequentie.
Zo beoordeel je de businesscase stap voor stap
- Kies één terugkerende taak met controleerbare antwoorden.
- Meet eerst hoe lang die zonder AI duurt.
- Geef ieder model dezelfde bronnen en opdracht.
- Noteer instellingen, datum en gebruikte hulpmiddelen.
- Meet ook beoordeling en herstelwerk.
- Herhaal de test met meerdere voorbeelden.
- Kies pas daarna een model of abonnement.
Gebruik voor een eerste proef fictieve of goedgekeurde, niet-vertrouwelijke gegevens. Controleer vóór zakelijk gebruik de voorwaarden van de specifieke dienst.
Onze conclusie: kies het werk, daarna het model
Gemini 4 Argon verdient een plek op de shortlist voor omvangrijke documentanalyse en complexe meerstapsopdrachten. De gepubliceerde cijfers ondersteunen die belangstelling, maar laten ook duidelijke verschillen per taak zien.
Voor WegwijsAI zou de doorslaggevende vraag zijn: kun je het resultaat sneller controleren dan je het zelf kunt maken?
Als het antwoord nee is, helpt een hogere benchmarkscore je weinig. Begin daarom klein. Eén afgebakende opdracht leert je meer dan een avond wisselen tussen modellen.
Wil je eerst bepalen welke toepassing bij jouw werk past? Gebruik onze keuzehulp voor AI-tools vergelijken.
FAQ
Is Gemini 4 Argon beter dan GPT-6 Astra of Claude?
Niet voor iedere taak. In de officiële vergelijking scoort Argon hoger op verschillende kenniswerk- en documentgerichte tests. GPT-6 Astra staat onder andere hoger op FrontierSWE v2. Claude Opus 5.5 staat hoger op Terminal-bench 4.0. Kies daarom op basis van een eigen, controleerbare praktijktest.
Kan Argon één miljoen tokens tegelijk lezen én schrijven?
Nee, niet als twee afzonderlijke budgetten van ieder één miljoen. De officiële documentatie beschrijft één gedeeld budget voor invoer en uitvoer, inclusief redeneerverwerking. Voor zeer lange uitvoer zijn bovendien aanvullende verwerkingsstappen nodig.
Kun je de antwoorden zonder controle gebruiken?
Dat is niet verstandig bij belangrijke beslissingen. Google noemt verzonnen informatie als bekende beperking. Laat daarom bronnen, berekeningen en voorgestelde wijzigingen controleren voordat je erop handelt.
Dit artikel is geschreven en gecontroleerd door Maarten en Sanne van WegwijsAI.
Over de auteur