Perplexity modellen vergelijken: Claude, Grok of Kimi?Leestijd: maximaal 16 minuten
Wie de Perplexity modellen opent, krijgt meer dan één slimme assistent te zien. Je kunt onder meer kiezen uit Claude, Grok en Kimi. Dat lijkt handig, maar roept meteen een nieuwe vraag op: welk model moet je gebruiken?
Het korte antwoord: Claude is meestal de beste keuze voor zorgvuldige analyse, Grok voor een frisse of technische tweede blik en Kimi voor grote hoeveelheden informatie. Toch bepaalt niet alleen het model de kwaliteit. Perplexity zoekt eerst bronnen en geeft die informatie daarna aan het gekozen model. Daardoor vergelijk je niet simpelweg Claude met Grok of Kimi, maar drie modellen die door dezelfde Perplexity-onderzoekslaag worden gevoed.

Niet alle Perplexity-modellen zijn gratis
De mogelijkheid om zelf Claude, Grok of Kimi te kiezen, is niet standaard gratis. In een gratis account gebruikt Perplexity vooral de automatische optie Best en krijg je slechts beperkt toegang tot uitgebreidere zoekopdrachten. Voor het handmatig selecteren van geavanceerde modellen heb je een betaald abonnement nodig. Welke modellen beschikbaar zijn, verschilt bovendien per abonnement en kan veranderen. Controleer daarom altijd de modelkiezer in je eigen account.
Snel antwoord: welk Perplexity-model kies je?
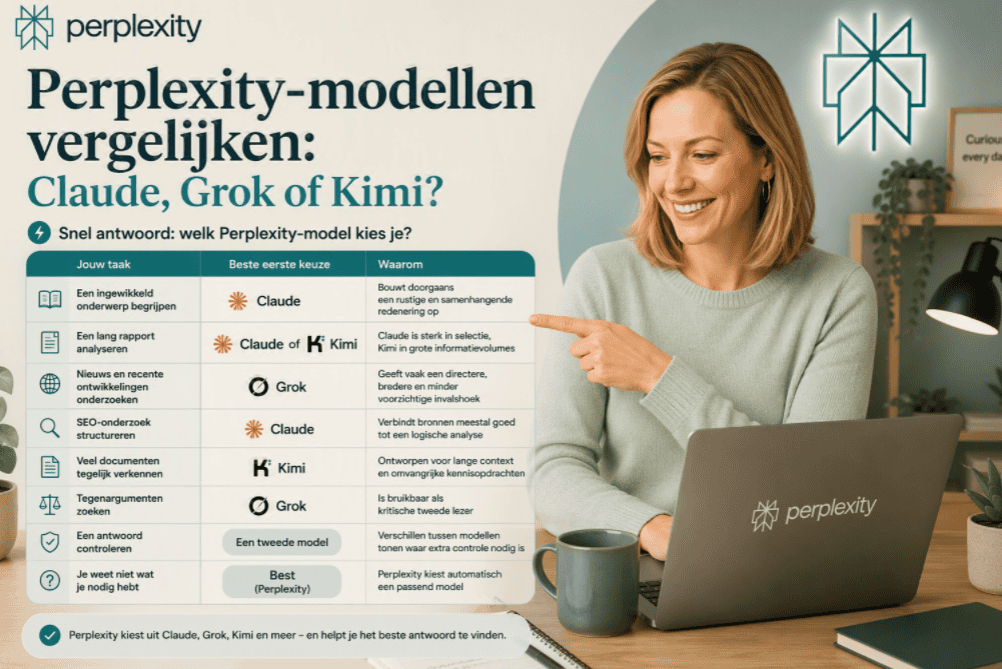
| Jouw taak | Beste eerste keuze | Waarom |
|---|---|---|
| Een ingewikkeld onderwerp begrijpen | Claude | Bouwt doorgaans een rustige en samenhangende redenering op |
| Een lang rapport analyseren | Claude of Kimi | Claude is sterk in selectie, Kimi in grote informatievolumes |
| Nieuws en recente ontwikkelingen onderzoeken | Grok | Geeft vaak een directere, bredere en minder voorzichtige invalshoek |
| SEO-onderzoek structureren | Claude | Verbindt bronnen meestal goed tot een logische analyse |
| Veel documenten tegelijk verkennen | Kimi | Ontworpen voor lange context en omvangrijke kennisopdrachten |
| Tegenargumenten zoeken | Grok | Is bruikbaar als kritische tweede lezer |
| Een antwoord controleren | Een tweede model | Verschillen tussen modellen tonen waar extra controle nodig is |
| Je weet niet wat je nodig hebt | Best | Perplexity kiest automatisch een passend model |
Onze praktische keuze bij WegwijsAI is daarom: begin met Claude, controleer belangrijke aannames met Grok en zet Kimi in wanneer de hoeveelheid informatie het grootste probleem is.
Dat is geen eeuwige ranglijst. Modellen worden regelmatig vervangen. Bovendien kan een nieuwe versie binnen enkele maanden andere sterke en zwakke punten hebben.
Waarom biedt Perplexity verschillende modellen aan?
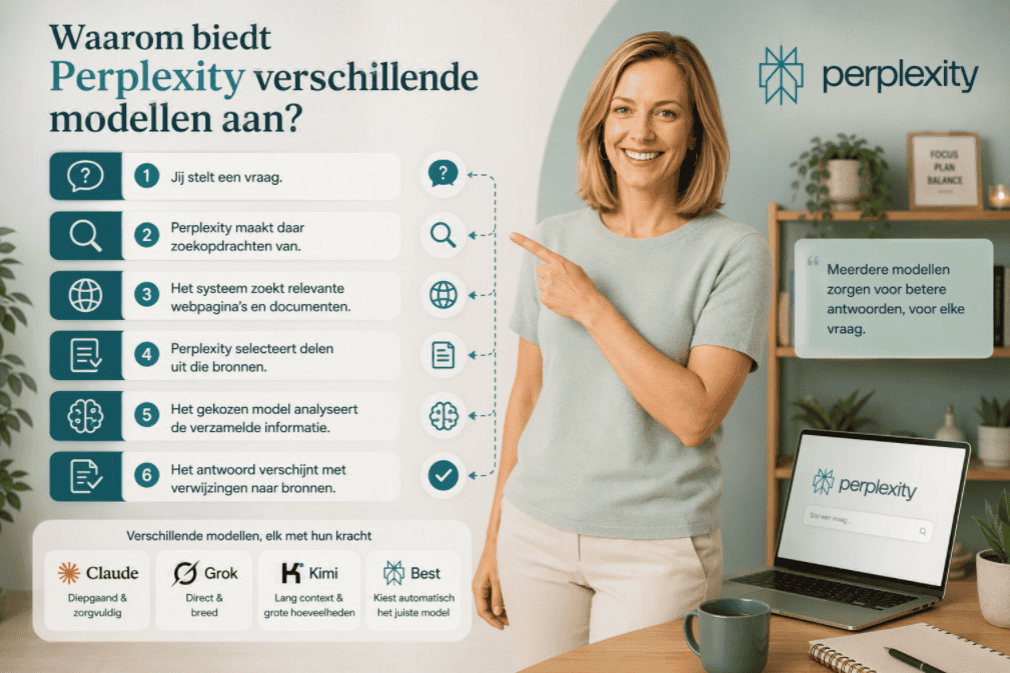
Perplexity is niet alleen een chatbot. Het is een combinatie van zoeken, bronnen selecteren, informatie ordenen en een antwoord laten formuleren.
Een vereenvoudigde route ziet er zo uit:
- Jij stelt een vraag.
- Perplexity maakt daar zoekopdrachten van.
- Het systeem zoekt relevante webpagina’s en documenten.
- Perplexity selecteert delen uit die bronnen.
- Het gekozen model analyseert de verzamelde informatie.
- Het antwoord verschijnt met verwijzingen naar bronnen.
Perplexity omschrijft Pro Search zelf als een proces waarin meerdere zoekacties worden uitgevoerd en informatie uit verschillende soorten bronnen wordt samengevoegd. Het gekozen model staat dus niet alleen met zijn eigen trainingskennis aan het werk.
Hier zit het eerste tegenintuïtieve inzicht: een sterker model hoeft binnen Perplexity niet automatisch een beter onderzoeksantwoord te geven.
Als Perplexity vooraf matige bronnen selecteert, kan zelfs het beste model daar geen betrouwbaar rapport van maken. Andersom kan een iets minder krachtig model met vijf goede primaire bronnen toch het nuttigste antwoord geven.
Daarom biedt Perplexity meerdere modellen aan. Volgens het bedrijf varieert modelkwaliteit sterk per taak. Wat goed werkt voor programmeren, kan minder geschikt zijn voor onderzoek of creatief werk. Die gedachte lag ook achter Model Council, waarin meerdere modellen dezelfde vraag beantwoorden en een extra model overeenkomsten en verschillen verwerkt.
De keuze van een AI-model is één onderdeel van goed werken met Perplexity. Bekijk Alles over Perplexity voor meer uitleg over zoeken, research, functies en abonnementen.
Het verschil tussen Perplexity en het gekozen model
Dit onderscheid wordt in veel vergelijkingen overgeslagen.
Perplexity bepaalt vooral wat het model te zien krijgt.
Claude, Grok of Kimi bepaalt vooral wat er vervolgens met die informatie gebeurt.
Je kunt het vergelijken met drie analisten die hetzelfde dossier ontvangen:
- de eerste zoekt voorzichtig naar verbanden;
- de tweede test of de gebruikelijke uitleg wel klopt;
- de derde probeert het volledige dossier in één groot overzicht te verwerken.
De feiten in het dossier kunnen gelijk zijn. Toch verschilt de conclusie, omdat iedere analist andere informatie benadrukt.
Wil je eerst beter begrijpen hoe deze zoek- en bronnenlaag werkt? Lees dan onze uitleg over Wat is Perplexity. Daar leggen we uit waarom Perplexity anders antwoordt dan een gewone chatbot.
Waarom Claude vaak het beste Perplexity-model is
Claude is onze eerste keuze voor onderzoek waarbij samenhang belangrijker is dan snelheid.
Denk aan:
- een concurrentieanalyse;
- het vergelijken van tegenstrijdige onderzoeken;
- een rapport met veel voorwaarden;
- het analyseren van klantreacties;
- het voorbereiden van een advies;
- het omzetten van losse bronnen naar een logisch verhaal.
Anthropic positioneert Claude Sonnet 5 voor redeneren, gereedschapsgebruik, programmeren en kenniswerk. Het model kan langere taken plannen en informatie uit complexe, ongestructureerde bronnen omzetten in rapporten en analyses.
Wat Claude in de praktijk beter doet
Claude is niet alleen goed in het verzamelen van punten. Het bewaakt meestal beter hoe die punten met elkaar samenhangen.
Stel dat je vraagt:
Vergelijk drie Nederlandse aanbieders van zakelijke telefonie. Gebruik alleen actuele productpagina’s, benoem onzekerheden en trek geen conclusie wanneer prijzen niet rechtstreeks vergelijkbaar zijn.
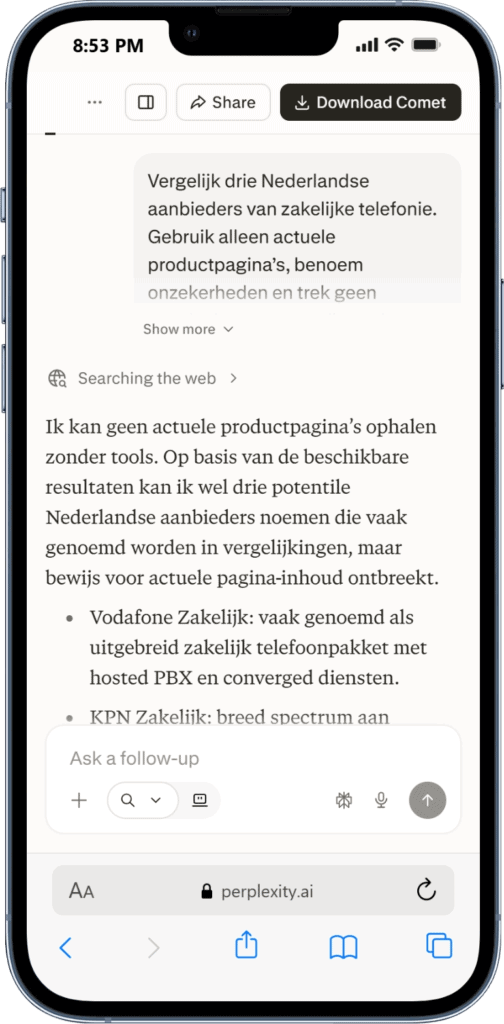
Een zwakker antwoord somt drie aanbieders op en kiest daarna een winnaar.
Een sterker antwoord merkt eerst op dat de abonnementen anders zijn opgebouwd. Vervolgens scheidt het vaste kosten, variabele kosten, looptijd en inbegrepen diensten. Pas daarna volgt een voorzichtige conclusie.
Juist in die tussenstappen is Claude vaak sterk. Het model probeert niet alleen een antwoord te produceren, maar bewaakt de redenering die naar dat antwoord leidt.
De gebruikerslaag, mechanische laag en interpretatielaag
Gebruikerslaag: het antwoord leest rustig en logisch.
Mechanische laag: Claude besteedt relatief veel aandacht aan relaties tussen voorwaarden, uitzonderingen en eerder genoemde informatie.
Interpretatielaag: je krijgt minder snel een verzameling feiten en vaker een bruikbaar besluitvormingsdocument.
Dat maakt Claude vooral geschikt voor taken waarbij één gemiste voorwaarde de conclusie kan veranderen.
Waar Claude minder handig is
Die zorgvuldigheid heeft ook een nadeel. Claude kan lang van stof zijn en soms voorzichtig blijven terwijl jij juist een scherpe keuze wilt.
Ook een goed geformuleerd Claude-antwoord is niet automatisch correct. De bronverwijzingen komen uit de zoeklaag van Perplexity. Je moet dus nog steeds controleren of een bron de claim werkelijk ondersteunt.
Wie Claude ook buiten Perplexity wil begrijpen, kan verder lezen in onze uitleg over wat Claude AI is en waarvoor je het gebruikt. Deze pagina heeft binnen de huidige interne linkstructuur nog relatief weinig verwijzingen en sluit inhoudelijk rechtstreeks aan.
Waarvoor is Grok binnen Perplexity beter?
Grok is interessant wanneer je niet alleen een correct geordend antwoord wilt, maar ook een andere invalshoek.
Grok 4.5 wordt door de maker gepositioneerd voor programmeren, technische taken en kenniswerk. Het model ondersteunt redeneren en kan grote hoeveelheden tekst en beeld verwerken.
Toch ligt de praktische waarde binnen Perplexity vooral ergens anders: Grok formuleert vaak directer en durft sneller een alternatieve verklaring naar voren te brengen.
Dat maakt het bruikbaar voor:
- actuele marktontwikkelingen;
- trendonderzoek;
- tegenargumenten;
- technische analyses;
- scenario’s waarin de standaardverklaring mogelijk onvolledig is;
- een tweede beoordeling van een te keurig antwoord.
Grok als kritische tweede lezer
Stel dat Claude concludeert dat een daling in websiteverkeer vooral door seizoensinvloed komt. Vraag Grok vervolgens:
Zoek drie andere verklaringen voor deze daling. Geef per verklaring aan welk bewijs we nodig hebben om die te bevestigen of uit te sluiten.
Dan gebruik je Grok niet als absolute waarheid, maar als tegenspeler.
Dat is slimmer dan Grok alleen te vragen naar “de oorzaak”. Bij één open vraag kan een model snel een pakkende verklaring kiezen. Door expliciet bewijs en uitsluitingscriteria te eisen, verandert een mening in een toetsbaar onderzoek.
Het risico van een overtuigende invalshoek
Een frisse conclusie voelt al snel intelligenter dan een voorzichtige uitleg. Dat is gevaarlijk.
Een onverwachte verklaring kan:
- werkelijk een gemist verband blootleggen;
- gebaseerd zijn op een zwakke bron;
- logisch klinken, maar niet uit de gegevens volgen;
- te veel gewicht geven aan een recente discussie.
Gebruik Grok daarom bij belangrijke onderwerpen als hypothesemaker, niet als eindjury.
Wil je beter begrijpen waar die directe stijl vandaan komt? In wat is Grok en wat kun je ermee? lees je hoe Grok zich onderscheidt van andere AI-tools. Ook deze pagina zit volgens je overzicht nog ruim onder de grens van tien interne verwijzingen.
Waarvoor kies je Kimi?
Kimi is minder bekend dan Claude en Grok, maar juist daardoor interessant.
Moonshot AI ontwikkelde Kimi K3 voor langdurige taken, kenniswerk, redeneren en het verwerken van een zeer grote context. Het officiële model ondersteunt een context van één miljoen tokens en kan tekst en beeld verwerken.
Voor een gewone zoekvraag merk je daar weinig van. Het verschil ontstaat wanneer je veel bronnen, lange documenten of meerdere soorten informatie tegelijk wilt meenemen.
Wanneer Kimi een logische keuze is

Kies Kimi bijvoorbeeld wanneer je:
- een grote verzameling onderzoeksrapporten wilt verkennen;
- lange documenten naast elkaar wilt leggen;
- patronen in veel productinformatie zoekt;
- eerst breed wilt verzamelen voordat je conclusies trekt;
- technische en visuele informatie wilt combineren;
- wilt voorkomen dat oudere informatie vroeg uit de analyse verdwijnt.
Waarom een groter geheugen niet automatisch een beter antwoord geeft
Dit is het tweede tegenintuïtieve inzicht: meer context kan het antwoord ook slechter maken.
Wanneer je twintig rapporten toevoegt, staan daar waarschijnlijk doublures, verouderde cijfers en tegenstrijdige definities in. Een model kan die hoeveelheid verwerken, maar moet nog steeds bepalen wat belangrijk is.
Kimi is daarom vooral sterk in de eerste onderzoeksfase:
- laat het model de informatie inventariseren;
- vraag om verschillen en tegenstrijdigheden;
- laat belangrijke claims koppelen aan de oorspronkelijke bron;
- gebruik daarna Claude om de kern te structureren;
- controleer de conclusie zelf.
Kimi is dus niet per definitie de beste schrijver of eindredacteur. Het is vooral een krachtige informatiebreker wanneer het dossier te groot wordt voor een eenvoudige analyse.
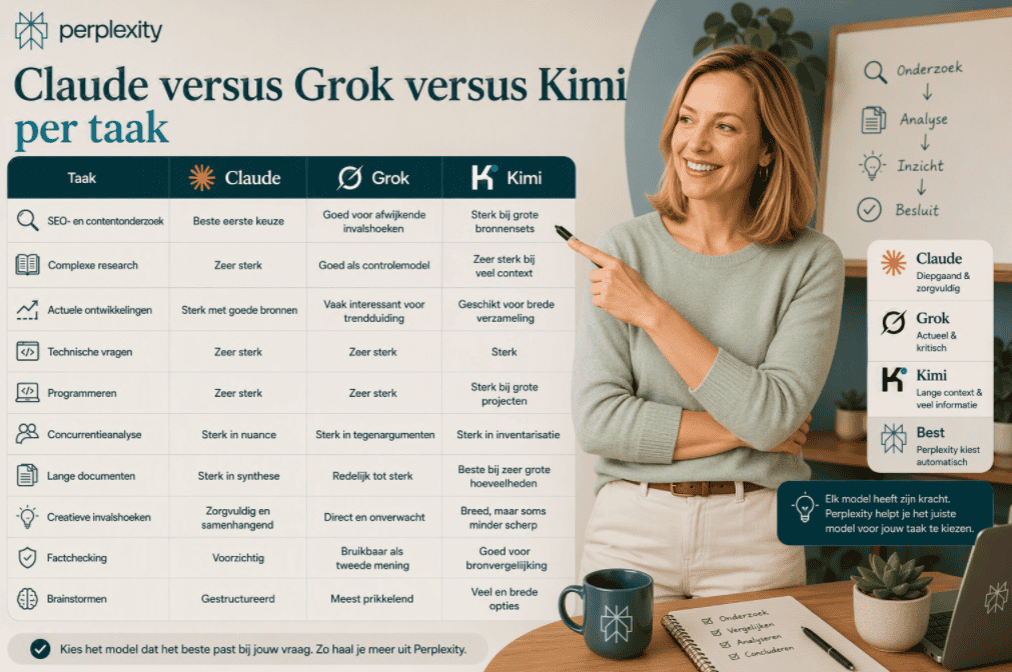
Claude versus Grok versus Kimi per taak
| Taak | Claude | Grok | Kimi |
|---|---|---|---|
| SEO- en contentonderzoek | Beste eerste keuze | Goed voor afwijkende invalshoeken | Sterk bij grote bronnensets |
| Complexe research | Zeer sterk | Goed als controlemodel | Zeer sterk bij veel context |
| Actuele ontwikkelingen | Sterk met goede bronnen | Vaak interessant voor trendduiding | Geschikt voor brede verzameling |
| Technische vragen | Zeer sterk | Zeer sterk | Sterk |
| Programmeren | Zeer sterk | Zeer sterk | Sterk bij grote projecten |
| Concurrentieanalyse | Sterk in nuance | Sterk in tegenargumenten | Sterk in inventarisatie |
| Lange documenten | Sterk in synthese | Redelijk tot sterk | Beste bij zeer grote hoeveelheden |
| Creatieve invalshoeken | Zorgvuldig en samenhangend | Direct en onverwacht | Breed, maar soms minder scherp |
| Factchecking | Voorzichtig | Bruikbaar als tweede mening | Goed voor bronvergelijking |
| Brainstormen | Gestructureerd | Meest prikkelend | Veel en brede opties |
Deze tabel is een praktische WegwijsAI-keuzehulp, geen officiële benchmark. Het resultaat kan veranderen door je prompt, de geselecteerde bronnen, de ingestelde zoekmodus en de actuele modelversie.
Veelvoorkomend misverstand: Grok heeft binnen Perplexity altijd toegang tot X
Grok wordt vaak direct gekoppeld aan actuele informatie op X. Daardoor ontstaat het idee dat Grok binnen iedere andere dienst automatisch dezelfde toegang heeft.
Dat hoeft niet zo te zijn.
Wanneer je Grok in Perplexity gebruikt, werkt het model binnen de zoek- en bronomgeving die Perplexity aanbiedt. Het is daarom niet verstandig om zonder controle aan te nemen dat alle mogelijkheden van de losse Grok-dienst identiek beschikbaar zijn.
Hetzelfde geldt voor Claude en Kimi. Een model binnen Perplexity is niet noodzakelijk dezelfde ervaring als dat model in de eigen app van de maker.
Zo test je zelf welk Perplexity-model beter is
Gebruik niet drie verschillende vragen. Dan weet je nog steeds niet of het verschil door het model of door de opdracht komt.
Stap 1: kies één echte onderzoeksvraag
Gebruik bij voorkeur een vraag waarvan je een deel van het antwoord kunt controleren.
Bijvoorbeeld:
Vergelijk drie Nederlandse energieleveranciers op vaste kosten, looptijd en voorwaarden. Gebruik alleen primaire bronnen en noteer wanneer gegevens niet vergelijkbaar zijn.
Stap 2: gebruik exact dezelfde prompt
Voer dezelfde prompt afzonderlijk uit met Claude, Grok en Kimi.
Verander geen woorden. Zelfs een kleine aanpassing kan het zoekproces beïnvloeden.
Stap 3: beoordeel vijf onderdelen
Geef ieder antwoord maximaal vijf punten voor:
- kwaliteit van de bronnen;
- ondersteuning van belangrijke claims;
- omgang met onzekerheid;
- structuur van de redenering;
- praktische bruikbaarheid.
Stap 4: controleer drie claims handmatig
Open per antwoord minimaal drie bronverwijzingen.
Controleer niet alleen of het onderwerp op de pagina staat. Kijk of de bron de volledige bewering ondersteunt.
Stap 5: zoek actief naar verschillen
Leg de antwoorden naast elkaar en noteer:
- waar de modellen het eens zijn;
- waar zij elkaar tegenspreken;
- welke informatie maar één model noemt;
- welk model een onzekerheid erkent;
- welk model het meest stellig klinkt.
Op dit punt begint de echte analyse. Overeenstemming tussen modellen is geen bewijs, maar verschil is wel een waarschuwing om verder te kijken.
De beste workflow is vaak geen enkel model
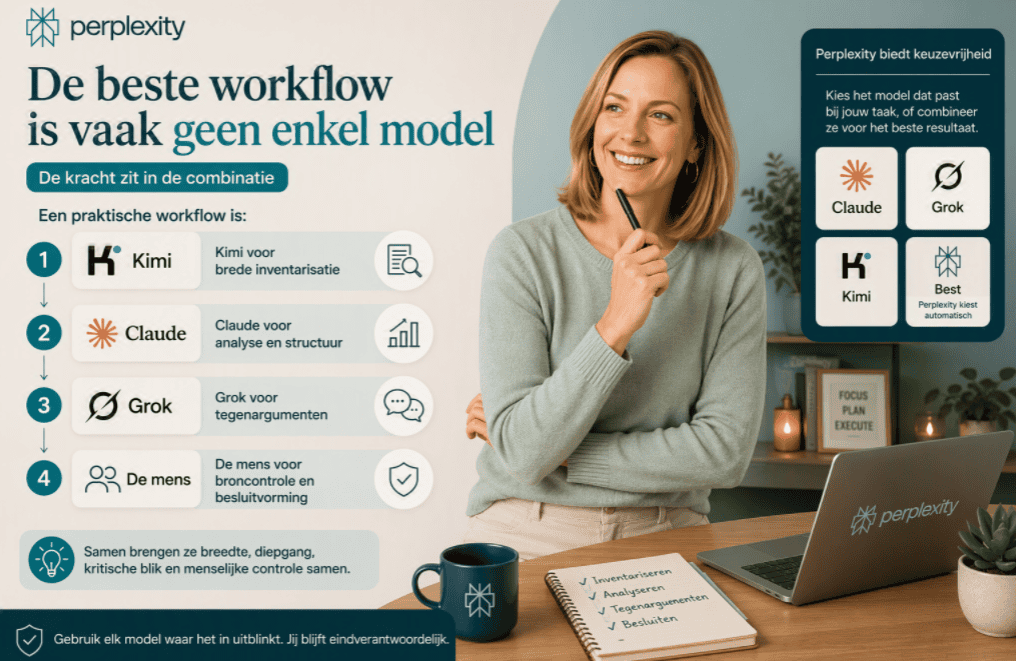
Een marketeer onderzoekt bijvoorbeeld waarom een concurrent plotseling vaker zichtbaar wordt in Google. Kimi verzamelt productpagina’s, publicaties, interviews en wijzigingen over een langere periode. Claude ordent daarna de mogelijke oorzaken in inhoud, techniek, merkbekendheid en externe links. Grok krijgt ten slotte de opdracht om de conclusie aan te vallen.
Het nuttige resultaat ontstaat niet doordat één model “wint”. Het ontstaat doordat ieder model een andere rol krijgt.
Een praktische workflow is:
- Kimi voor brede inventarisatie
- Claude voor analyse en structuur
- Grok voor tegenargumenten
- De mens voor broncontrole en besluitvorming
Dat laatste onderdeel kun je niet uitbesteden. Een model ziet patronen, maar kent niet automatisch jouw doel, risicobereidheid of organisatiecontext.
Wanneer kun je gewoon de optie Best gebruiken?
Niet iedere vraag verdient een modelvergelijking.
Gebruik Best bij:
- eenvoudige feitelijke vragen;
- een eerste oriëntatie;
- korte samenvattingen;
- vragen zonder grote gevolgen;
- situaties waarin snelheid belangrijker is dan de exacte schrijfstijl.
Perplexity omschrijft Best als de automatische modeloptie die per zoekopdracht een passend model selecteert. Deep Research selecteert modellen eveneens automatisch. Handmatig kiezen is vooral nuttig wanneer je een specifieke werkwijze of tweede beoordeling nodig hebt.
Ons oordeel over de beste Perplexity modellen
Voor de meeste gebruikers is Claude de beste algemene keuze. Niet omdat Claude altijd de meeste feiten vindt, maar omdat het model complexe informatie vaak omzet in een rustige, bruikbare redenering.
Grok kies je wanneer je een directere blik, technische benadering of stevig tegenargument nodig hebt. Het model is vooral waardevol wanneer je voorkomt dat één keurige analyse ongemerkt de enige waarheid wordt.
Kimi kies je wanneer de hoeveelheid informatie de uitdaging vormt. Het model komt het best tot zijn recht bij lange documenten, grote bronnensets en brede inventarisaties.
De echte kracht van Perplexity zit daarom niet in het vinden van één winnaar. Het platform laat je verschillende denkstijlen gebruiken boven op dezelfde onderzoeksomgeving.
Wil je eerst rustig oefenen met zoeken, doorvragen en bronnen controleren? Begin dan met één model en voer dezelfde opdracht daarna met een tweede model uit. Zo merk je vanzelf waar formulering stopt en echte inhoudelijke verschillen beginnen.
Dit artikel is geschreven en gecontroleerd door Maarten en Sanne van WegwijsAI.
FAQ
Welk Perplexity-model is het beste?
Claude is voor veel gebruikers de beste eerste keuze bij analyse, lange antwoorden en ingewikkelde onderzoeksvragen. Grok is interessant voor een kritische of technische tweede blik. Kimi past vooral bij lange documenten en grote hoeveelheden informatie. De beste keuze hangt dus af van de taak.
Waarom geeft ieder Perplexity-model een ander antwoord?
Perplexity verzamelt bronnen, waarna het gekozen model de informatie interpreteert en formuleert. Claude, Grok en Kimi zijn anders ontwikkeld en leggen daardoor andere verbanden. Ze kunnen met grotendeels dezelfde bronnen toch andere details benadrukken of een andere conclusie trekken.
Kun je Claude, Grok en Kimi gratis gebruiken in Perplexity?
Perplexity laat gratis gebruikers de automatische optie Best gebruiken en biedt een beperkt aantal uitgebreidere zoekopdrachten. Het handmatig selecteren van geavanceerde modellen is volgens Perplexity gekoppeld aan betaalde abonnementen. Het actuele aanbod kan veranderen, dus controleer altijd de modelkiezer van je eigen account.
Is Kimi beter dan Claude voor lange documenten?
Kimi is ontworpen voor zeer grote hoeveelheden context en is daardoor interessant voor omvangrijke bronnensets. Claude is vaak sterker wanneer de kerninformatie vervolgens zorgvuldig moet worden geselecteerd en omgezet in een samenhangende conclusie. Voor belangrijk onderzoek kun je beide modellen na elkaar gebruiken.
Is Grok binnen Perplexity hetzelfde als Grok op X?
Niet noodzakelijk. Binnen Perplexity werkt Grok met de zoekomgeving, bronselectie en instellingen van Perplexity. Functies of databronnen die in de eigen Grok-omgeving beschikbaar zijn, hoeven niet op exact dezelfde manier binnen Perplexity te werken.
Over de auteur